Mengukur akurasi agen AI untuk sewa jangka pendek: 380 pertanyaan, nol jawaban salah
Studi tentang Santi, agen AI di Santara AI: 19 pertanyaan operasional masing-masing diajukan 20 kali pada portofolio sungguhan dan dinilai terhadap dasbor. 0 dari 380 jawaban salah; 377 lengkap dan benar (99,2%); median waktu jawab 6,4 detik.
 Tai Pham
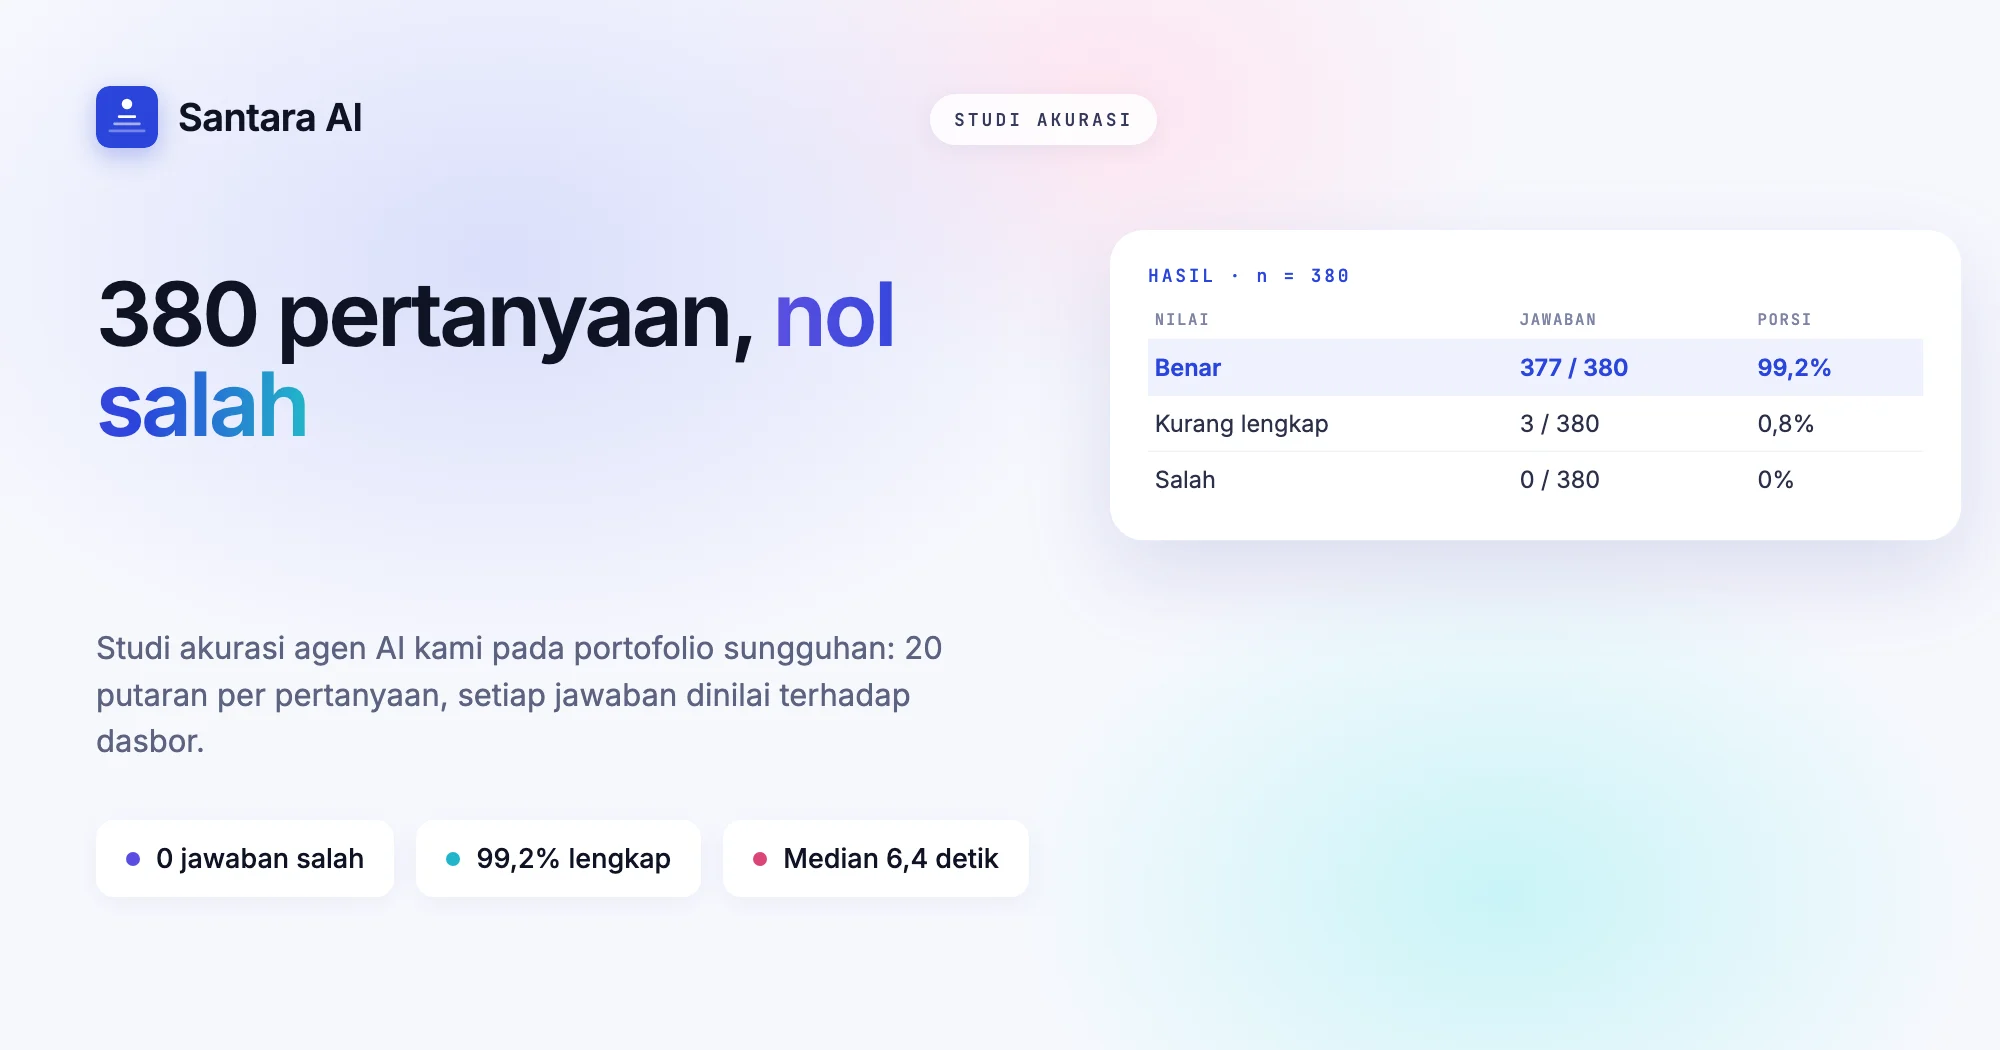
Abstrak. Kami mengukur akurasi faktual Santi, agen AI di Santara AI, pada portofolio sewa jangka pendek yang beroperasi. Sembilan belas pertanyaan operasional masing-masing diajukan 20 kali (n = 380) melalui layanan produksi, dengan riwayat percakapan dihapus setelah setiap jawaban, dan setiap jawaban dinilai terhadap angka di dasbor Santara AI. Tidak ada jawaban yang memuat angka salah (0 dari 380; IK 95% 0,0–1,0%). 377 jawaban lengkap dan benar (99,2%; IK 95% 97,7–99,7%) dan 3 kurang lengkap (0,8%). Median waktu hingga jawaban lengkap adalah 6,4 detik (IQR 5,4–8,3 detik). Tulisan ini memaparkan metode, hasil per pertanyaan, analisis tiga jawaban yang kurang lengkap, dan perubahan yang dilakukan setelah studi.
1. Pendahuluan
Agen AI yang mengelola bisnis sewa hanya berguna jika angkanya dapat dipercaya: "14 kedatangan minggu depan" menentukan siapa yang membersihkan, siapa yang menyambut, dan bagaimana malam kosong diberi harga. Demo produk menunjukkan jawaban yang benar; demo tidak menunjukkan seberapa sering sistem itu benar. Studi ini mengukur tingkat tersebut secara langsung, pada data operasional sungguhan, dengan dasbor sistem itu sendiri sebagai acuan.
2. Metode
2.1 Sistem yang diuji
Santi adalah agen AI di dalam Santara AI. Santi menjawab dengan membaca booking, kotak masuk, ulasan, pendapatan, dan laporan pemilik milik host melalui alat yang hanya membaca, dan setiap perubahan yang diusulkan memerlukan konfirmasi host dua kali. Setiap jawaban yang membaca data diakhiri baris sumber: kapan data dibaca dan tautan ke layar Santara AI asalnya. Layanan produksi diuji sebagaimana berjalan pada 13 Oktober 2026.
2.2 Data
Satu portofolio yang beroperasi dengan 12 listing sewa jangka pendek di Asia Tenggara, dengan okupansi 92% pada hari pengujian. Demi melindungi pemilik dan tamu, nama portofolio dan nama tamu tidak diungkapkan, dan hasil terkait uang hanya dilaporkan cocok atau tidak cocok.
2.3 Pertanyaan
Sembilan belas pertanyaan dalam empat kategori (Lampiran A): jumlah (booking, malam, okupansi, pergantian tamu, kotak masuk, ulasan; 10 pertanyaan), nama tamu (kedatangan dan kepergian; 4), uang (pendapatan, tarif per malam, laporan pemilik; 3), dan bahasa lain (pertanyaan check-in dalam bahasa Vietnam dan Indonesia; 2). Semua pertanyaan hanya membaca data.
2.4 Prosedur
Setiap pertanyaan diajukan 20 kali, dalam 20 putaran bergilir berisi ke-19 pertanyaan, melalui endpoint streaming yang sama dengan yang dipakai aplikasi Santi, masuk sebagai host. Riwayat percakapan dihapus setelah setiap jawaban, sehingga tidak ada jawaban yang bergantung pada jawaban sebelumnya. Setelah 380 putaran otomatis, ke-19 pertanyaan juga diketik sekali di halaman chat sungguhan lewat browser.
2.5 Nilai acuan dan penilaian
Nilai acuan dibaca dari Santara AI di awal pengujian: kalender, jumlah di kotak masuk, total halaman Ulasan, laporan pemilik, dan Daily Brief. Setiap jawaban dinilai dalam tiga tingkat:
- Benar: menyebut nilai acuan (uang selisih paling banyak 1%) atau menyebut nama semua tamu, dalam bahasa yang ditanyakan.
- Kurang lengkap: tidak memuat angka salah, tetapi menghilangkan sebagian yang ditanyakan.
- Salah: menyebut angka atau nama yang bertentangan dengan acuan.
Penilaian dilakukan otomatis dengan pencocokan teks; setiap jawaban yang tidak dinilai benar kemudian dibaca ulang secara manual.
2.6 Statistik
Proporsi dilaporkan dengan interval kepercayaan (IK) Wilson 95%, yang tetap valid pada sampel kecil dan pada 0% atau 100%. Waktu jawab adalah waktu nyata dari pertanyaan dikirim hingga jawaban selesai, dilaporkan sebagai median dan rentang antarkuartil (IQR).
3. Hasil
3.1 Akurasi
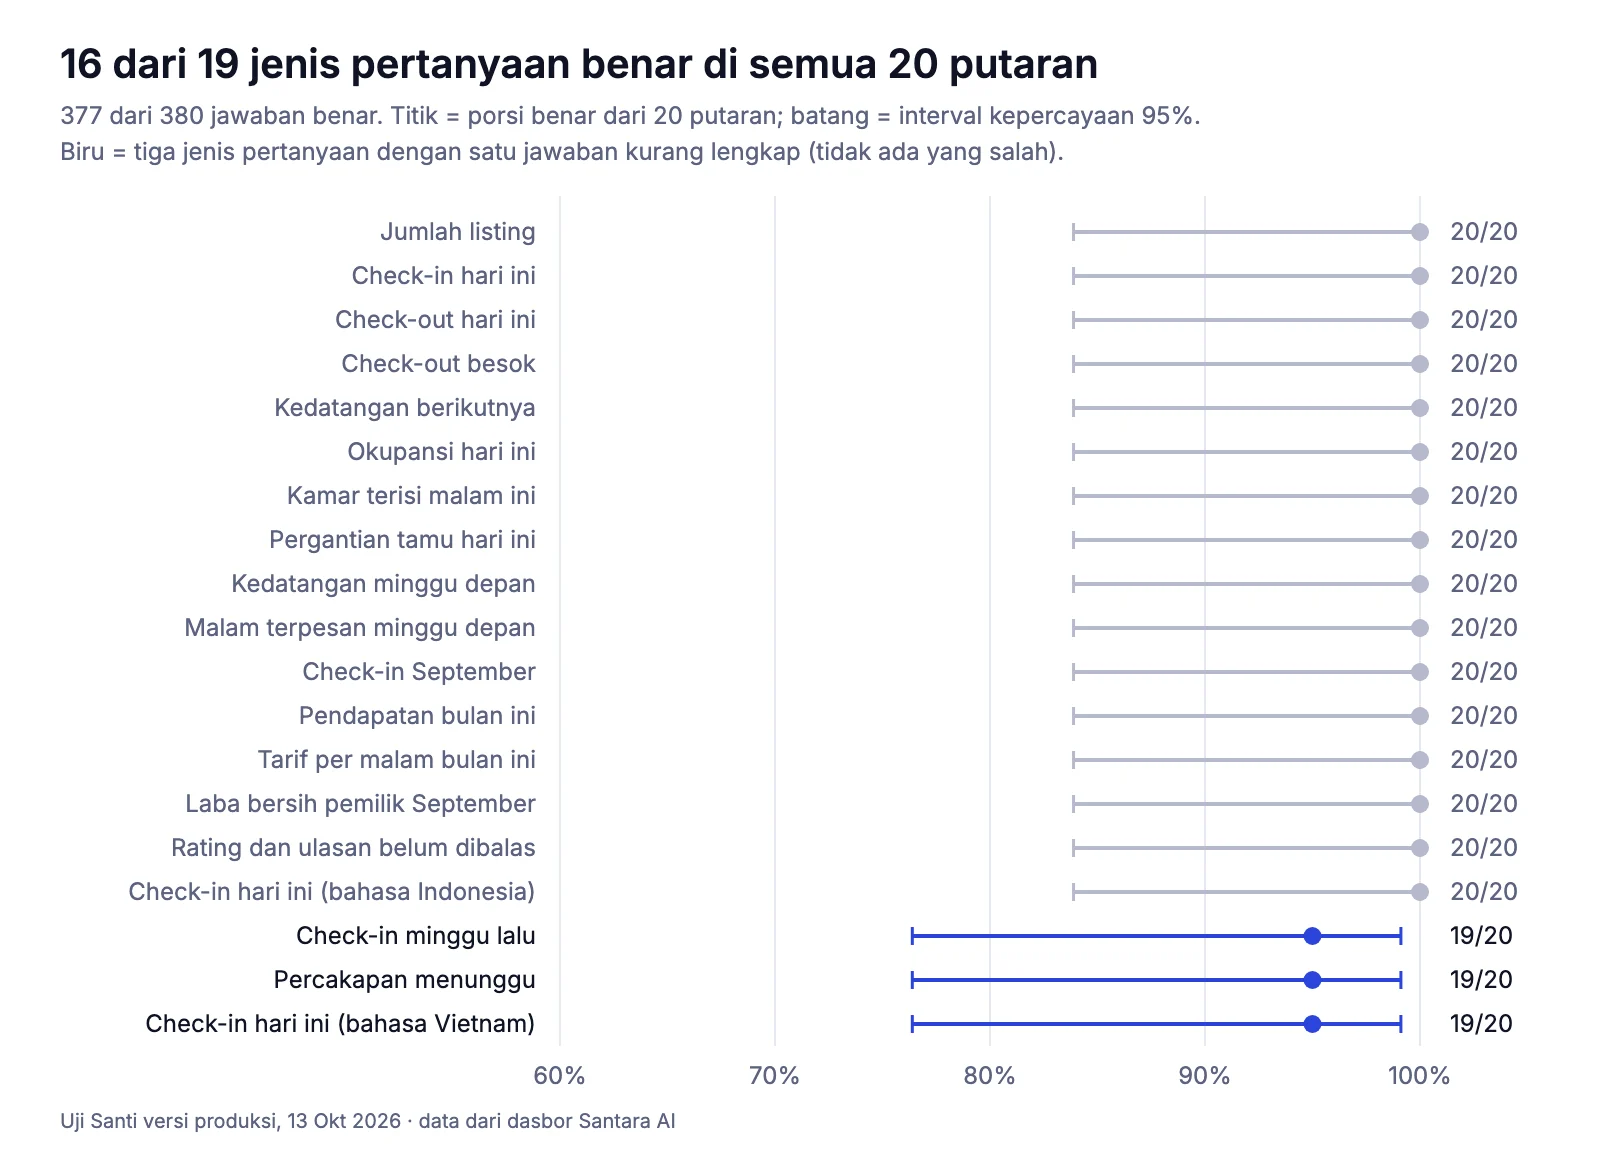
Tidak ada jawaban yang salah. Enam belas dari 19 pertanyaan dijawab benar di semua 20 putaran; tiga lainnya benar 19 dari 20 (Gambar 1).
Tabel 1. Hasil per kategori (n = 380).
| Kategori | Pertanyaan | Benar | Kurang lengkap | Salah |
| Jumlah | 10 | 198 / 200 | 2 | 0 |
| Nama tamu | 4 | 80 / 80 | 0 | 0 |
| Uang | 3 | 60 / 60 | 0 | 0 |
| Bahasa lain | 2 | 39 / 40 | 1 | 0 |
| Semua | 19 | 377 / 380 (99,2%; IK 97,7–99,7%) | 3 (0,8%) | 0 (IK 0,0–1,0%) |
Semua jawaban soal uang cocok dengan dasbor, termasuk laporan pemilik, yang mengurangi pendapatan kotor dengan biaya kanal dan pengeluaran, serta menempatkan setiap masa inap pada bulan check-out. Uji lewat halaman chat sungguhan memberi hasil yang sama: 19 dari 19 benar.
3.2 Waktu jawab
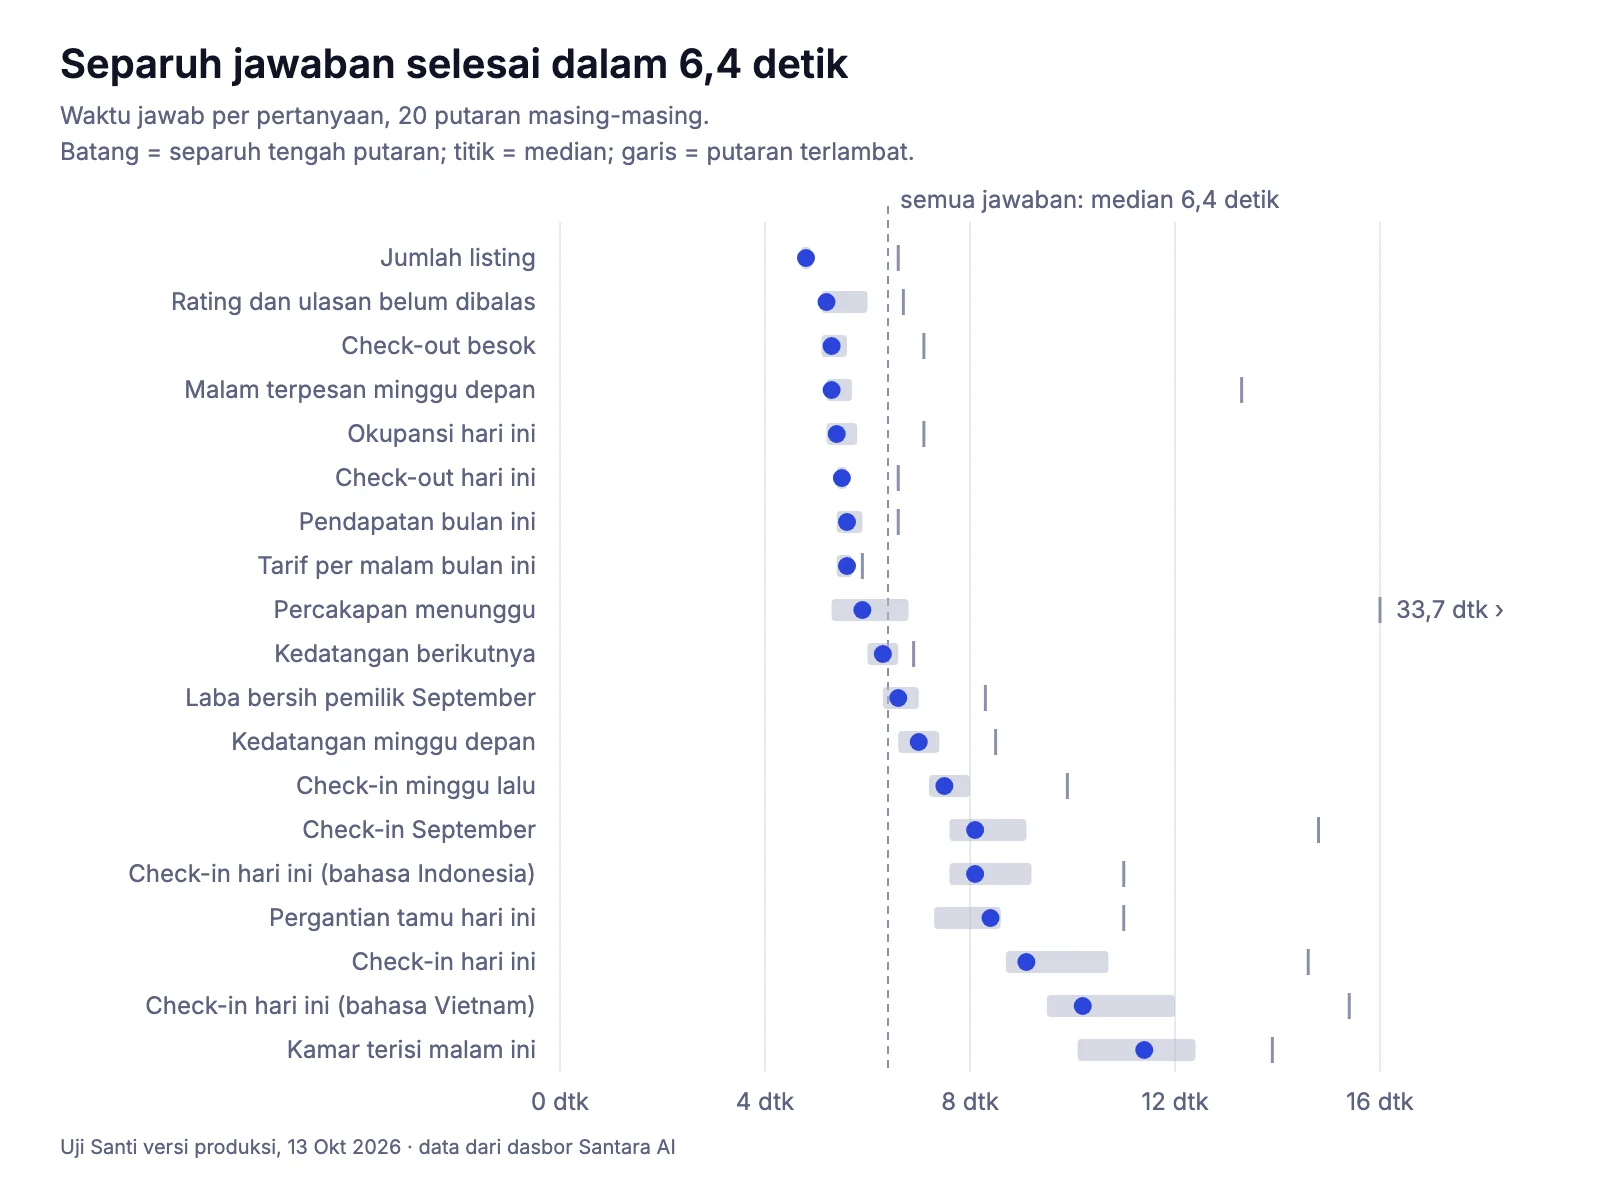
Median waktu hingga jawaban lengkap adalah 6,4 detik (IQR 5,4–8,3 detik; persentil ke-95 12,0 detik; maksimum 33,7 detik, satu putaran). Kata pertama muncul setelah median 4,5 detik. Pencarian tunggal butuh sekitar 5 detik; pertanyaan yang menggabungkan beberapa sumber, seperti kamar terisi malam ini, butuh sekitar 10 detik (Gambar 2).
3.3 Sinyal pendukung
Tabel 2. Sinyal yang memungkinkan host memverifikasi jawaban.
| Sinyal | Hasil |
| Jawaban dengan baris sumber (waktu baca + tautan) | 379 / 380 |
| Hari dalam minggu disebut benar untuk tanggalnya | 379 / 380 |
| Dijawab dalam bahasa yang ditanyakan | 40 / 40 |
| Peringatan pencocokan yang ditampilkan | 22, semuanya pada angka yang benar |
Santi menandai setiap angka dalam jawabannya yang tidak ada di data yang dibacanya. Ke-22 tanda itu jatuh pada angka yang dihitung sendiri dengan benar, bukan dibaca: jumlah pos pengeluaran sebulan (20 putaran) dan tarif per malam setelah biaya (2 putaran). Dengan demikian, dalam studi ini pemeriksaan tidak melewatkan apa pun dan menghasilkan 22 peringatan palsu.
4. Analisis kesalahan
Setiap jawaban yang kurang lengkap memiliki penyebab berbeda (Tabel 3).
Tabel 3. Tiga jawaban yang kurang lengkap.
| Pertanyaan | Putaran | Yang diterima host | Penyebab |
| Tamu yang check-in minggu lalu | 8 / 20 | Tidak ada balasan; bertanya lagi memberi angka benar, 14 | Model mengakhiri giliran tanpa menulis setelah pencarian yang benar; belum ada percobaan ulang otomatis |
| Percakapan yang menunggu balasan | 17 / 20 | "12 minggu ini, ditambah 29 yang lebih lama", tanpa total 41 | Alat mengembalikan angka dalam dua bagian, dan agen diminta tidak pernah menjumlahkan sendiri |
| Siapa yang check-in hari ini (bahasa Vietnam) | 11 / 20 | "Hari ini 3 tamu check-in", dengan 2 dari 3 nama di teks | Daftar kedatangan sudah tampil di layar sebagai kartu, dan agen diminta tidak mengulang kartu; host tetap melihat ketiga nama |
Satu jawaban lain, yang dinilai benar, dibuka dengan "18 tamu check-in minggu lalu" sebelum dikoreksi menjadi 14, karena 4 booking di antaranya dibatalkan. Angka akhirnya benar, tetapi kalimat pertamanya menyesatkan.
5. Pembahasan
Hasil ini mendukung dua klaim. Pertama, pada data ini agen tidak menyebut angka yang salah: dari 380 jawaban, batas atas interval 95% untuk jawaban salah adalah 1,0%. Kedua, kesalahan yang tersisa adalah kelalaian akibat aturan desain agen itu sendiri, bukan salah membaca data, sehingga dapat diperbaiki secara langsung.
Ketiganya sudah diperbaiki dan dirilis setelah studi:
- giliran yang sudah mencari data tetapi tidak menulis apa pun kini meminta jawabannya sekali lagi;
- "berapa yang menunggu" kini menyebut total lebih dulu, baru rinciannya;
- pertanyaan langsung (siapa, berapa) dijawab lengkap dengan kata-kata, walaupun kartu di layar sudah menampilkan daftar yang sama.
Uji ulang terhadap tiga pertanyaan yang terdampak ditambah satu pertanyaan kontrol berbahasa Inggris (20 putaran) menghasilkan 20 dari 20 jawaban lengkap dan benar. Dua perubahan masih berjalan: alat akan mengirim setiap angka total yang dibutuhkan agen, menghapus 22 peringatan palsu; dan pengujian berikutnya akan menilai kalimat pertama yang menyesatkan sebagai kurang lengkap.
6. Keterbatasan
Satu portofolio, satu hari, dan satu set nilai acuan; hasil dapat berbeda pada portofolio yang lebih besar atau kurang aktif. Penilaian menggunakan pencocokan teks otomatis dengan pembacaan ulang manual atas setiap jawaban yang tidak benar. Satu nilai acuan, jumlah percakapan di kotak masuk, berubah selama pengujian dan diterima dalam ±1. Uji ulang setelah perbaikan lebih kecil (20 putaran) dan berjalan pada ruang kerja uji yang terpisah.
7. Kesimpulan
Dari 380 jawaban produksi pada portofolio yang beroperasi, Santi tidak menyebut satu pun angka yang salah, menjawab 99,2% pertanyaan secara lengkap dan benar, dan memberi jawaban lengkap dalam median 6,4 detik, masing-masing dengan tautan ke layar asalnya. Tiga jawaban yang kurang lengkap telah diperbaiki. Kami akan mengulang studi ini seiring Santi berkembang dan menerbitkan hasilnya.
Anda bisa mengajukan pertanyaan ini kepada Santi tentang bisnis Anda sendiri: coba Santi dan cocokkan jawabannya dengan dasbor Santara AI Anda.
Lampiran A. Pertanyaan dan hasil
Jawaban benar dari 20 putaran, dan median waktu hingga jawaban lengkap.
| # | Pertanyaan | Kategori | Benar | Median waktu |
| 1 | Berapa listing yang saya punya? | Jumlah | 20 / 20 | 4,8 detik |
| 2 | Siapa yang check-in hari ini? | Nama | 20 / 20 | 9,1 detik |
| 3 | Siapa yang check-out hari ini? | Nama | 20 / 20 | 5,5 detik |
| 4 | Siapa yang check-out besok? | Nama | 20 / 20 | 5,3 detik |
| 5 | Kapan kedatangan berikutnya setelah hari ini, dan siapa? | Nama | 20 / 20 | 6,3 detik |
| 6 | Berapa okupansi saya hari ini? | Jumlah | 20 / 20 | 5,4 detik |
| 7 | Berapa kamar yang terisi malam ini? | Jumlah | 20 / 20 | 11,4 detik |
| 8 | Berapa pergantian tamu hari ini? | Jumlah | 20 / 20 | 8,4 detik |
| 9 | Berapa kedatangan minggu depan? | Jumlah | 20 / 20 | 7,0 detik |
| 10 | Berapa malam yang terpesan minggu depan? | Jumlah | 20 / 20 | 5,3 detik |
| 11 | Berapa tamu yang check-in minggu lalu? | Jumlah | 19 / 20 | 7,5 detik |
| 12 | Berapa booking yang check-in di bulan September? | Jumlah | 20 / 20 | 8,1 detik |
| 13 | Berapa pendapatan saya bulan ini sejauh ini? | Uang | 20 / 20 | 5,6 detik |
| 14 | Berapa tarif rata-rata per malam bulan ini sejauh ini? | Uang | 20 / 20 | 5,6 detik |
| 15 | Berapa laba bersih pemilik untuk September? | Uang | 20 / 20 | 6,6 detik |
| 16 | Berapa percakapan tamu yang menunggu balasan saya? | Jumlah | 19 / 20 | 5,9 detik |
| 17 | Berapa rating ulasan rata-rata saya, dan berapa ulasan yang belum saya balas? | Jumlah | 20 / 20 | 5,2 detik |
| 18 | Hôm nay ai nhận phòng? (ditanyakan dalam bahasa Vietnam) | Bahasa | 19 / 20 | 10,2 detik |
| 19 | Siapa yang check-in hari ini? (ditanyakan dalam bahasa Indonesia) | Bahasa | 20 / 20 | 8,1 detik |
Pertanyaan 1–17 diajukan dalam bahasa Inggris dalam studi ini; tabel mencantumkan terjemahannya agar mudah dibaca.